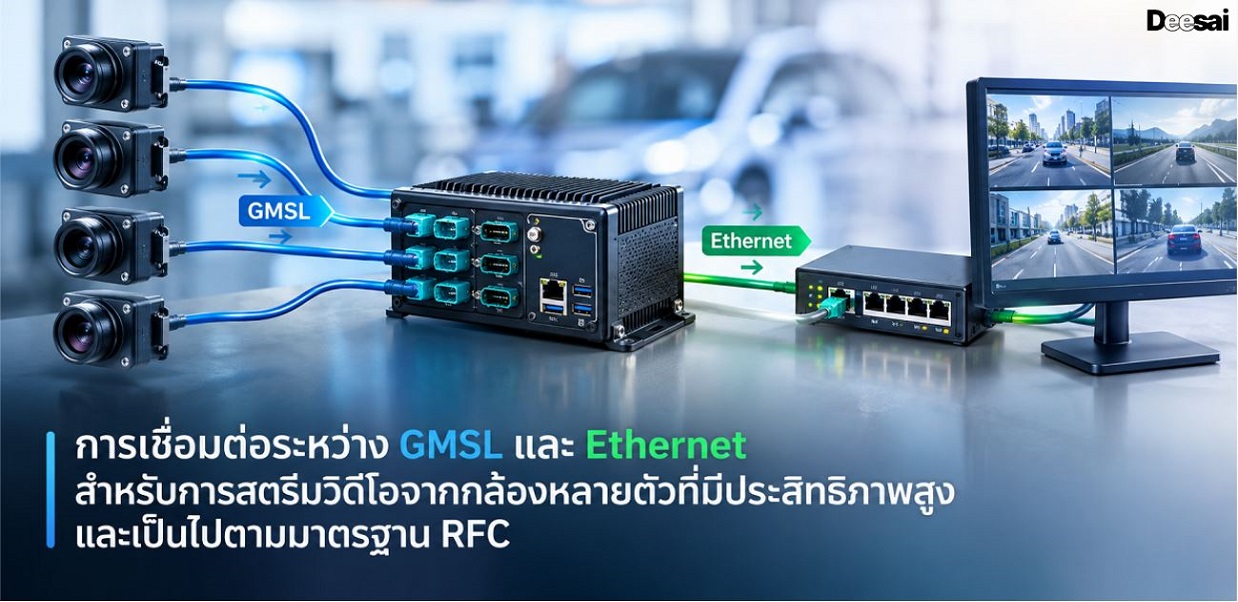
การเชื่อมต่อระหว่าง GMSL และ Ethernet สำหรับการสตรีมวิดีโอจากกล้องหลายตัวที่มีประสิทธิภาพสูงและเป็นไปตามมาตรฐาน RFC

ค้นพบว่าการเชื่อมต่อระหว่าง GMSL และ Ethernet ช่วยปลดล็อกศักยภาพในการสตรีมวิดีโอจากกล้องหลายตัวด้วยความเร็วสูงและราบรื่นได้อย่างไร
การเชื่อมต่อระหว่าง GMSL และ Ethernet สำหรับการสตรีมวิดีโอจากกล้องหลายตัวที่มีประสิทธิภาพสูงและเป็นไปตามมาตรฐาน RFC

บทความนี้เสนอวิธีการบูรณาการเทคโนโลยี Gigabit Multimedia Serial Link (GMSL) ™เข้ากับโดเมนอีเธอร์เน็ตได้อย่างราบรื่น เพื่อสร้างกระบวนการสตรีมมิ่งวิดีโอหลายกล้องความเร็วสูง ความหน่วงต่ำ และเป็นไปตามมาตรฐาน RFC อย่างสมบูรณ์ เพื่อให้ได้ประโยชน์จากประสิทธิภาพสูง ประหยัดพลังงาน และสถาปัตยกรรมที่ยืดหยุ่น กระบวนการสตรีมมิ่งวิดีโอความเร็วสูงทั้งหมดจึงถูกนำไปใช้โดยใช้ประโยชน์จากทรัพยากร FPGA

แนะนำ

ระบบอัตโนมัติทางอุตสาหกรรมผ่านหุ่นยนต์อัตโนมัติ1และการขับขี่อัตโนมัติ2ถือเป็นหนึ่งในเทคโนโลยีเกิดใหม่ที่สำคัญที่สุดของทศวรรษ 2020 หนึ่งในองค์ประกอบสำคัญของการใช้งานดังกล่าวคือการส่งสัญญาณวิดีโอ ซึ่งแสดงข้อมูลแบบเรียลไทม์เกี่ยวกับสภาพแวดล้อมของหุ่นยนต์หรือยานพาหนะ ด้วยวิธีนี้ เทคโนโลยี Gigabit Multimedia Serial Link (GMSL ™ ) มีบทบาทสำคัญในการให้ลิงก์วิดีโอความเร็วสูงที่มีประสิทธิภาพด้านต้นทุนผ่านสายไฟเส้นเดียวระหว่างโมดูลกล้องหลายตัว และเกี่ยวข้องกับการประมวลผลเซิร์ฟเวอร์ระบบบนชิป (SoC) ในทางกลับกัน เนื่องจากอุปกรณ์ส่วนใหญ่ที่ใช้ในองค์ประกอบอัตโนมัติต่างๆ นั้นเชื่อมต่อกันเป็นเครือข่าย มาตรฐานอีเธอร์เน็ตจึงกลายเป็นวิธีการส่งข้อมูลที่สำคัญ ซึ่งแสดงให้เห็นถึงความหลากหลายของการใช้งานความเร็วสูง ดังนั้น เทคโนโลยีการสตรีมวิดีโอจึงมีบทบาทสำคัญในการรับประกันความเร็วและมาตรฐานการส่งพิกเซลของกล้องระหว่างโฮสต์ SoC และอุปกรณ์เครือข่ายอื่นๆ จากสภาพแวดล้อม แง่มุมที่สำคัญที่สุดที่พิจารณาสำหรับการสตรีมวิดีโอคือความเร็วสูงและความหน่วงต่ำ ด้วยวิธีนี้ อุปกรณ์ FPGA จึงเป็นตัวเลือกที่ดีที่สุดเนื่องจากมีความยืดหยุ่นในการประมวลผลแบบขนานและการใช้งาน บทความนี้อธิบายถึงประสิทธิภาพการส่งวิดีโอระดับสูงไปยังบริการแพ็กเก็ตเครือข่าย IP และการกระจายวิดีโอโดยใช้โปรโตคอลการขนส่งแบบเรียลไทม์ (RTP) ซึ่งสามารถทำได้โดยการใช้ทรัพยากร FPGA อย่างเต็มที่ เพื่อแสดงให้เห็นถึงแนวทางที่นำเสนอ จะใช้สถานการณ์การสตรีมวิดีโอหลายกล้อง GMSL บนแพลตฟอร์มการประมวลผลแบบ Edge Computing ADRD8012-01Z ที่มีประสิทธิภาพสูง ความหน่วงต่ำ และคุ้มค่าเป็นตัวอย่าง

เทคโนโลยี GMSL และข้อกำหนด RTP

เทคโนโลยี GMSL ของ ADI เป็นโซลูชัน SERDES ที่ปรับขนาดได้และคุ้มค่า ออกแบบมาเพื่อส่งข้อมูลวิดีโอแบบเรียลไทม์ ข้อมูลควบคุม และพลังงานผ่านสายเคเบิลเพียงเส้นเดียว มีสถาปัตยกรรมสองแบบ: แบบหนึ่งสำหรับการเชื่อมต่อแบบอนุกรมที่มีความน่าเชื่อถือสูงระหว่างโมดูลกล้องและระบบ SoC แบบฝังตัว และอีกแบบหนึ่งระหว่าง SoC แบบฝังตัวและอุปกรณ์แสดงผล เทคโนโลยี GMSL ที่ใช้กล้องนั้นถูกนำไปใช้อย่างแพร่หลายในภาคยานยนต์ และปัจจุบันมีบทบาทสำคัญในการขับขี่อัตโนมัติ โดยให้การเชื่อมต่อวิดีโอความเร็วสูงที่มีประสิทธิภาพจากหลายส่วนของยานพาหนะโดยใช้สายเคเบิลให้น้อยที่สุด ยิ่งไปกว่านั้น ยังมีประโยชน์ในแอปพลิเคชันต่างๆ จากตลาดหุ่นยนต์ อุตสาหกรรม เครื่องมือวัด และการดูแลสุขภาพอีกด้วย

เพื่อให้สามารถส่งข้อมูลด้วยสายเดี่ยวตามที่กล่าวมาข้างต้น จึงได้มีการนำเทคโนโลยี SERDES ประสิทธิภาพสูงมาใช้ ซึ่งประกอบด้วยส่วนประกอบหลักสองส่วน ได้แก่ ตัวแปลงอนุกรม GMSL และตัวแปลงลำดับ GMSL ในบริบทของกล้อง ตัวแปลงอนุกรมจะแปลงข้อมูลวิดีโอแบบขนานความเร็วสูงที่มาจากอินเทอร์เฟซอนุกรมกล้องเวอร์ชัน 2 (CSI-2) ไปยังอินเทอร์เฟซเอาต์พุตของกล้อง ส่วนประกอบถัดไปในกลไกการส่งข้อมูล GMSL คือลิงก์อนุกรมความเร็วสูง ซึ่งมีความเร็วสูงสุดถึง 3 Gbps ใน GMSL1 สูงสุด 6 Gbps ใน GMSL2 และสูงสุด 12 Gbps ใน GMSL3 โดยใช้สายโคแอกเซียลหรือสายคู่บิดเกลียวหุ้มฉนวน (STP) สุดท้าย ตัวแปลงลำดับจะคลายการบีบอัดข้อมูลที่มาจากอุปกรณ์อนุกรมหลายตัว แล้วแปลงข้อมูลนั้นไปยังอินเทอร์เฟซเอาต์พุต CSI-2 หนึ่งตัวหรือมากกว่า เพื่อให้สามารถส่งข้อมูลแบบแบ่งเวลาได้ อุปกรณ์ GMSL จะใช้คุณสมบัติช่องสัญญาณเสมือนที่เสนอไว้ในข้อกำหนด MIPI CSI-2 ตัวระบุช่องสัญญาณเสมือนแสดงถึงกลไกการสลับข้อมูลแบบง่าย ๆ ที่ช่วยให้ตัวรับสามารถตีความเฟรมที่ได้รับจากแหล่งวิดีโอหลายแหล่งได้อย่างง่ายดายโดยใช้ค่า ID ที่กำหนดไว้

ภาพที่ 1 แสดงการเชื่อมต่อทั่วไประหว่างกล้องที่รองรับ GMSL จำนวน 4 ตัวกับวงจรรับสัญญาณ CSI-2 ที่รวมอยู่ในพื้นที่ FPGA ของ Xilinx SoC โดยใช้ตัวรับสัญญาณ CSI-2 และตัวควบคุม I2C เพื่อจัดการทั้งข้อมูลวิดีโอและการควบคุม
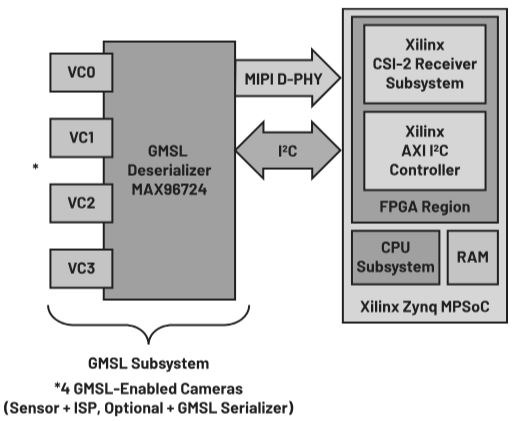
รูปที่ 1. ลำดับการส่งข้อมูล GMSL CSI-2 ไปยัง FPGA โดยใช้ MAX96724

RTP 4เป็นข้อกำหนดที่ใช้กันทั่วไปสำหรับการสตรีมวิดีโอผ่านเครือข่าย IP โดยทั่วไปจะใช้กลไกการขนส่งแบบไม่ต้องเชื่อมต่อที่มีความหน่วงต่ำโดยใช้ User Datagram Protocol (UDP) 5และกำหนดรูปแบบแพ็กเก็ตหลายแบบเพื่อรวมรูปแบบเพย์โหลดวิดีโอต่างๆ รูปที่ 2 แสดงแพ็กเก็ต RTP ทั่วไปสำหรับวิดีโอที่ไม่ได้บีบอัด 6ซึ่งมีส่วนหัว RTP ทั่วไป ส่วนหัวเพย์โหลด และบรรทัดสตรีมวิดีโอเฉพาะหลายบรรทัด ไม่ว่าจะเป็นบางส่วนหรือทั้งหมด เนื่องจากโปรโตคอล RTP ทำหน้าที่เป็นการใช้งานในเลเยอร์แอปพลิเคชัน จึงมีฟิลด์ที่จำเป็นทั้งหมดที่สามารถกำหนดลักษณะของข้อมูลเพย์โหลดได้อย่างละเอียด ในกรณีนี้ ฟิลด์สตรีม ประเภทวิดีโอ หรือเฟรมสุดท้ายเป็นฟิลด์เฉพาะแอปพลิเคชันหลายฟิลด์
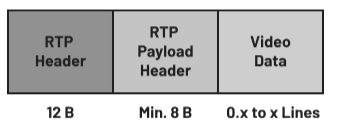
รูปที่ 2 รูปแบบแพ็กเก็ต RTP

สแต็กเครือข่ายแบบไม่เชื่อมต่อจะใช้ FPGA แทนระบบย่อย CPU

เมื่อเทคโนโลยีระบบอัตโนมัติพัฒนาขึ้นในช่วงทศวรรษ 2020 ความต้องการโซลูชันที่เป็นนวัตกรรมใหม่ก็เพิ่มขึ้นอย่างมากในหลายตลาด เช่น การขับขี่อัตโนมัติ หรือระบบอัตโนมัติทางอุตสาหกรรมผ่านหุ่นยนต์ นอกจากการใช้เครือข่ายเซ็นเซอร์ที่หลากหลายและอัลกอริธึม AI ที่ซับซ้อนแล้ว การสตรีมวิดีโอความเร็วสูงและมีความหน่วงต่ำก็มีบทบาทสำคัญอย่างยิ่งเมื่อพูดถึงการขับขี่อัตโนมัติหรือหุ่นยนต์อัจฉริยะ เช่น หุ่นยนต์ฮิวมานอยด์ ในกรณีนี้ การส่งข้อมูลวิดีโอแบบเรียลไทม์ถือเป็นสิ่งสำคัญที่สุดที่ต้องพิจารณา หรือนำไปสู่ความจำเป็นในการพึ่งพาวิธีการส่งข้อมูลแบบไร้การเชื่อมต่อ คุณสมบัติ RTP ที่กล่าวถึงข้างต้นเป็นเสาหลักสำคัญเมื่อพูดถึงการใช้งานการสตรีมวิดีโอแบบเรียลไทม์ ซึ่งออกแบบมาโดยคำนึงถึงข้อกำหนดการส่งข้อมูล UDP และผ่านเครือข่าย IP เป็นหลัก

แม้ว่าการสตรีมวิดีโอแบบไร้การเชื่อมต่อจะส่งผลให้มีการใช้ทรัพยากรน้อยลงและมีประสิทธิภาพสูงกว่าเมื่อเทียบกับการออกแบบที่เน้นการเชื่อมต่อโดยใช้สแต็ก TCP/IP แต่ก็ยังสามารถปรับปรุงให้ดียิ่งขึ้นได้ เนื่องจากในบริบทของยานยนต์และอุตสาหกรรม การสตรีมวิดีโอส่วนใหญ่มักทำระหว่างระบบฝังตัวที่มีการเชื่อมต่อฮาร์ดแวร์ (HW) โดยตรงกับแหล่งวิดีโอ การปรับปรุงนี้สามารถทำได้โดยการใช้โซลูชันฮาร์ดแวร์ต่างๆ เช่น ระบบย่อย CPU ประสิทธิภาพสูงที่ใช้ในศูนย์ข้อมูล แม้ว่าอุปกรณ์ประมวลผลเหล่านี้จะสามารถแก้ไขช่องว่างด้านประสิทธิภาพในกระบวนการสตรีมวิดีโอทั่วไปได้ แต่ต้นทุนและความซับซ้อนทำให้ไม่เหมาะสมกับสภาพแวดล้อม SoC แบบฝังตัว ซึ่งต้องการส่วนประกอบที่ได้รับการปรับให้เหมาะสมทั้งด้านประสิทธิภาพและการประหยัดพลังงาน นอกจากนี้ อุปกรณ์ GPU ยังเป็นทางเลือกหนึ่งสำหรับการประมวลผลประสิทธิภาพสูง โดยใช้ประโยชน์จากการทำงานแบบขนานจำนวนมาก แต่มีความยืดหยุ่นในระดับฮาร์ดแวร์น้อยกว่า

ด้วยเหตุนี้ FPGA ที่สามารถกำหนดค่าใหม่ได้อย่างมากจึงกลายเป็นส่วนประกอบสำคัญเมื่อพูดถึงเครือข่ายประสิทธิภาพสูงและการสตรีมวิดีโอแบบเรียลไทม์ เพื่อเพิ่มประสิทธิภาพการประมวลผลแบบ Edge Computing ให้สูงสุด SoC แบบฝังตัวในปัจจุบันจึงรวมระบบย่อย CPU ทรัพยากร FPGA และ RAM ไว้ในชิปเดียว ดังนั้น อุปกรณ์ประเภทนี้จึงสามารถเป็นตัวเลือกการประมวลผลที่ดีที่สุดสำหรับการสตรีมวิดีโอแบบเรียลไทม์ สามารถรับข้อมูลวิดีโอ แปลงพิกเซลวิดีโอที่ได้รับเป็นแพ็กเก็ตเครือข่าย และสตรีมวิดีโอโดยใช้การประมวลผล CPU น้อยที่สุด ซึ่งใช้สำหรับการกำหนดค่าฟิลด์โปรโตคอล ดังนั้น การแปลงข้อมูลวิดีโอเป็นแพ็กเก็ตเครือข่ายอย่างสมบูรณ์และการสตรีมวิดีโอแบบไร้การเชื่อมต่อจึงสามารถทำได้โดยให้ประสิทธิภาพสูงสุดทั้งในแง่ของความหน่วงและอัตราข้อมูล แม้ว่าจะใช้โมดูลกล้องหนึ่งตัวหรือมากกว่าก็ตาม เพื่อให้ได้ประสิทธิภาพการส่งข้อมูลที่ดีที่สุดและความเหมาะสมกับทรัพยากร FPGA ที่มีอยู่ การออกแบบสถาปัตยกรรมสแต็กเครือข่ายนี้จึงมีโปรโตคอลเลเยอร์แอปพลิเคชัน (RFC) ที่สอดคล้องกับข้อกำหนดอย่างสมบูรณ์ และการออกแบบที่ควบคุมด้วยซอฟต์แวร์ (SW) น้อยที่สุดสำหรับข้อกำหนดเลเยอร์การขนส่ง เครือข่าย และลิงก์ข้อมูล ซึ่งจะแทนที่การใช้งานการกำหนดเส้นทาง IP แบบดั้งเดิมด้วยการกำหนดค่าฟิลด์ด้วยตนเองที่ง่ายขึ้นสำหรับการกำหนดที่อยู่ IP

แปลงชื่อโดเมนวิดีโอให้เข้ากับเครือข่าย

ดังที่กล่าวไว้ก่อนหน้านี้ เทคโนโลยี GMSL มีเป้าหมายในการแปลงข้อมูลวิดีโอที่มาจากโมดูลกล้องหลายตัวให้เป็นข้อมูลอนุกรม แล้วส่งออกสตรีมที่เชื่อมต่อกันผ่านการใช้งานมาตรฐาน เช่น CSI-2 ไปยัง SoC แบบฝังตัว เพื่อให้บรรลุการเชื่อมต่อนี้ เทคโนโลยีนี้ใช้กลไกช่องสัญญาณเสมือนแบบสลับกัน โดยใช้ความสามารถในการจัดเก็บข้อมูลที่มีอยู่ในอุปกรณ์ GMSL SERDES บทความนี้อธิบายถึงเส้นทางวิดีโอประสิทธิภาพสูง ความหน่วงต่ำ และไม่บีบอัด สำหรับการแปลงเป็นแพ็กเก็ตเครือข่าย IP เลือกใช้สแต็กการสตรีมวิดีโอแบบ RTP มาตรฐาน เนื่องจากมีการออกแบบส่วนหัวที่น้อยที่สุดและตัวเลือกเลเยอร์การขนส่งแบบไร้การเชื่อมต่อโดยใช้ UDP ด้วยวิธีการดังกล่าว สแต็กการสตรีมวิดีโอจึงเข้ากันได้กับการใช้งานซอฟต์แวร์หรือฮาร์ดแวร์ฝั่งรับอื่นๆ มากมาย และเป็นไปตามมาตรฐาน RTP RFC อย่างสมบูรณ์

แม้ว่าข้อกำหนด RTP สำหรับวิดีโอที่ไม่บีบอัดจะรวมถึงสถาปัตยกรรมที่มีสตรีมแบบแบ่งส่วน แต่แนวทางที่ดีที่สุดในการนำไปใช้เพื่อรองรับฮาร์ดแวร์คือการออกแบบที่ไม่แบ่งส่วน ซึ่งจะช่วยลดการใช้ทรัพยากรลงอย่างมาก พร้อมทั้งลดการใช้พลังงานให้น้อยที่สุด

ดังที่ได้กล่าวไปแล้ว มีอุปกรณ์ประมวลผลหลายชนิดที่สามารถแปลงสัญญาณวิดีโอเป็นสัญญาณเครือข่ายได้ นอกจากนี้ยังมีวิธีการส่งข้อมูลหลายวิธี รูปที่ 3, 4 และ 5 แสดงให้เห็นถึงความสามารถในการส่งข้อมูลผ่านหน่วยความจำโดยใช้ระบบฝังตัวที่ใช้ CPU/GPU/FPGA และสถาปัตยกรรมสแต็กการสตรีมวิดีโอแบบ FPGA เพียงอย่างเดียวที่กล่าวถึงในบทความนี้

รูปที่ 3 แสดงตัวเลือกที่สามารถเลือกได้เมื่อใช้งานสแต็กเครือข่ายที่เกี่ยวข้องกับการสตรีมวิดีโอโดยอิงตามการออกแบบร่วม HW/SW แบบคลาสสิก ดังนั้น ด้านซ้ายประกอบด้วยระบบย่อยตัวรับวิดีโอ ซึ่งจะส่งสตรีมวิดีโอไปยัง RAM ของระบบฝังตัวโดยใช้ตัวควบคุมการเข้าถึงหน่วยความจำโดยตรง (DMA) จากนั้นข้อมูลวิดีโอจะถูกอ่านจากหน่วยความจำและส่งไปยังตัวควบคุมการเข้าถึงสื่ออีเธอร์เน็ต (MAC) โดยใช้กลไกการออกแบบสแต็กเครือข่ายอย่างใดอย่างหนึ่งต่อไปนี้: (1) ชุดพัฒนา Data Plane (DPDK) 7หรือ (2) การใช้งานเครือข่ายแบบดั้งเดิมที่ใช้เคอร์เนล Linux 8สุดท้ายแล้ว Ethernet MAC จะส่งต่อแพ็กเก็ตเครือข่ายไปยัง Ethernet PHY ที่เชื่อมต่ออยู่
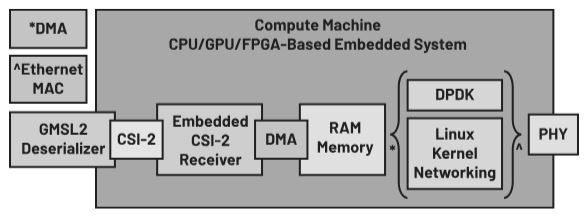
รูปที่ 3. การสตรีมวิดีโอแบบคลาสสิกโดยใช้หน่วยความจำ

ภาพที่ 4 แสดงให้เห็นถึงวิธีการใช้งานลำดับการส่งข้อมูลโดยใช้การเข้าถึงหน่วยความจำโดยตรงระยะไกล (RDMA) โดยแสดงให้เห็นถึงความจำเป็นในการใช้การ์ดอินเทอร์เฟซเครือข่าย (NIC) ที่รองรับ RDMA สำหรับทั้งฝั่งผู้ส่งและผู้รับ ดังที่แสดงในแผนภาพ การใช้งานเลเยอร์ 2 พื้นฐานนั้นอิงตามมาตรฐานอีเธอร์เน็ต ลำดับตัวอย่างนี้เป็นภาพรวมที่แสดงให้เห็นถึงวิธีการใช้งานการส่งข้อมูล RDMA ผ่านอีเธอร์เน็ตคอนเวอร์เจนซ์ (RoCE)
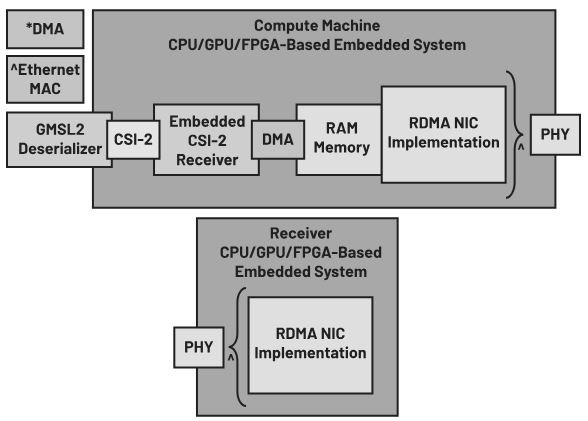
รูปที่ 4 การส่งสัญญาณวิดีโอโดยใช้ RDMA

ภาพที่ 5 นำเสนอภาพรวมของแนวทางในบทความนี้ โดยเผยให้เห็นส่วนประกอบที่สำคัญที่สุด ได้แก่ การแปลงเส้นทางวิดีโอที่ใช้ FPGA ไปเป็นแพ็กเก็ต RTP และโมดูลสแต็กเครือข่ายแบบไร้การเชื่อมต่อ
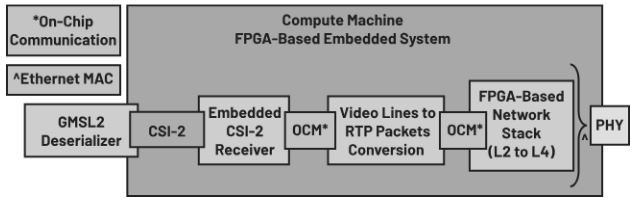
รูปที่ 5. เครื่องมือสตรีมมิ่งวิดีโอที่เร่งความเร็วด้วย FPGA

ภาพที่ 6 แสดงการแปลงข้อมูลวิดีโอ CSI-2 ไปเป็นการแปลงแพ็กเก็ต RTP อย่างสมบูรณ์ เพื่อประสิทธิภาพในการออกแบบการแปลง จึงเลือกการแปลงแบบ 1 บรรทัดเป็น 1 แพ็กเก็ต RTP ซึ่งเป็นวิธีที่ดีที่สุดทั้งในแง่ของการใช้ทรัพยากรและมาตรฐานอีเธอร์เน็ต เฟรมอีเธอร์เน็ตทั่วไปที่อิงตามหน่วยการส่งข้อมูลสูงสุด (MTU) ซึ่งเป็นหน่วยวัดที่ใช้ใน NIC ที่ผลิตจริง มีช่วง 1500 (ปกติ) หรือ 9000 (เฟรมจัมโบ้) และค่าสูงสุดทางทฤษฎี 65536 (เฟรมขนาดใหญ่พิเศษ) สำหรับกรณีการใช้งานทดลอง เนื่องจากวิดีโอหนึ่งบรรทัดแสดงถึงหลายพันไบต์ จึงเลือกสถาปัตยกรรมแบบ 1 บรรทัดเพื่อให้สอดคล้องกับการออกแบบ NIC ของตัวรับส่วนใหญ่ ดังที่ได้กล่าวไว้ก่อนหน้านี้ การแปลงข้อมูลวิดีโอเป็นแพ็กเก็ต RTP แบบซอฟต์แวร์อย่างเดียวหรือแบบฮาร์ดแวร์/ซอฟต์แวร์นั้นเกี่ยวข้องกับการอ่าน/เขียนหน่วยความจำจำนวนมากทั้งในระบบย่อยซอฟต์แวร์วิดีโอและเครือข่าย ซึ่งเพิ่มความซับซ้อนและลดประสิทธิภาพลงเนื่องจากความหน่วงสูง ในแนวทางฮาร์ดแวร์แบบเต็มรูปแบบนี้ ความซับซ้อนของการใช้งานจะลดลงเหลือน้อยที่สุด โดยมีกลไกการจัดเก็บข้อมูลเพียงอย่างเดียวสำหรับช่วงเวลาการส่งข้อมูลของแต่ละเส้นทาง จึงมั่นใจได้ว่าแพ็กเก็ตที่ส่งผ่านสายเคเบิลจะไม่ถูกแบ่งส่วน ในทางกลับกัน กลไกที่เรียบง่ายอย่างยิ่งนี้มีประโยชน์เฉพาะสำหรับการแปลงข้อมูลจากกลุ่มสตรีมวิดีโอที่แบ่งเวลาโดยใช้ความสามารถของช่องสัญญาณเสมือนเท่านั้น ในกรณีที่ใช้กลุ่มสตรีมวิดีโอที่แบ่งเวลาหลายกลุ่มแบบขนานกัน จำเป็นต้องเพิ่มระดับการจัดเก็บข้อมูลใหม่ลงในลำดับชั้นการส่งข้อมูล ซึ่งจะสร้างเส้นทางที่แบ่งเวลาไปยังระบบย่อยเครือข่าย
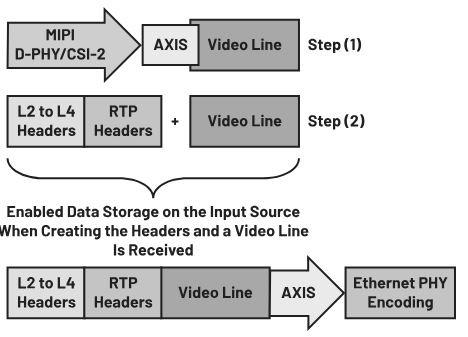
รูปที่ 6 การแปลงพิกเซลวิดีโอ (หนึ่งบรรทัด) เป็นแพ็กเก็ต RTP

ดังแสดงในรูปที่ 6 กระบวนการแปลประกอบด้วยสองขั้นตอน: (1) รวบรวมข้อมูลจากการใช้งานตัวรับ CSI-2 และสร้างแพ็กเก็ตตามสตรีมวิดีโอที่สอดคล้องกับ AXIS และ (2) สร้างแพ็กเก็ต RTP โดยการเพิ่มส่วนหัวโปรโตคอลลงในสตรีมวิดีโอ

แพลตฟอร์มการประมวลผลแบบ Edge Computing ADI GMSL ไปยัง 10 GbE

เพื่อใช้ประโยชน์จากข้อดีของการออกแบบการสตรีมวิดีโอ RTP ที่เร่งความเร็วด้วย FPGA อย่างเต็มรูปแบบ ADI จึงนำเสนอแพลตฟอร์มการประมวลผลแบบ Edge Computing รุ่น ADRD8012-01Z ซึ่งเป็นตัวแปลงสัญญาณ GMSL หลายกล้องประสิทธิภาพสูงเป็น 10 Gigabit Ethernet (GbE) ที่สร้างขึ้นบน AMD-Xilinx K26 SoM ที่คุ้มค่า ฮาร์ดแวร์ประกอบด้วยตัวแปลงสัญญาณอนุกรม MAX96724 สองตัวที่มี 4GMS ซึ่งสามารถรองรับสตรีมวิดีโอแบบขนานได้สูงสุด 8 กล้อง โดยแสดงเป็น 2 บล็อกของ 4 ช่องสัญญาณเสมือน (VC - VC0 ถึง VC3) ก่อนตัวแปลงสัญญาณอนุกรม ภาพที่ 7 แสดงลำดับการสตรีมวิดีโอทั้งหมด ในแง่ของเครือข่าย แพลตฟอร์มนี้มีขั้วต่อแบบเสียบได้ (SFP+) ที่สามารถใช้เพื่อส่งข้อมูลผ่านเครือข่าย 10 GbE ได้ โมดูลกล้องที่ทดสอบกับการใช้งานการสตรีมวิดีโอของผลิตภัณฑ์นี้มีดังนี้: กล้องระดับยานยนต์ C1 และ C2 คลาส IV ที่มีช่วงไดนามิกสูงถึง 120 dB และความละเอียด 2.5 MP/5.4 MP และ Intel RealSense D457 นอกจากนี้ โมดูลยังประกอบด้วยตัวประมวลผลภาพ (ISP) ในตัวที่เชื่อมต่อกับเซ็นเซอร์ภาพแต่ละตัว ทำให้สามารถส่งภาพสีเต็มรูปแบบตามข้อกำหนด YUV422 ได้ ตัวอย่างเช่น ดังที่กล่าวไว้ก่อนหน้านี้ ในบริบทของการสตรีมวิดีโอ ข้อกำหนดของเลเยอร์แอปพลิเคชันทำหน้าที่เป็นพื้นฐานสำหรับการแสดงโครงสร้างของเฟรม ในกรณีนี้ สำหรับการส่งวิดีโอแบบไม่บีบอัด ส่วนหัวของเพย์โหลด RTP 6จะกำหนดความยาวของแต่ละฟิลด์เพย์โหลด ซึ่งระบุความยาวบรรทัดจริง จำนวนบรรทัด และปัจจัยอื่นๆ ที่เกี่ยวข้องกับการแบ่งส่วนซึ่งไม่ได้พิจารณาในแนวทางของเอกสารนี้ ในทางกลับกัน ส่วนหัว RTP ทั่วไป4แสดงประเภทวิดีโอและค่าตัวระบุเครื่องหมาย โดยระบุไบต์สุดท้ายของเฟรมวิดีโอ ซึ่งตรงกับส่วนตรรกะ TVALID/TLAST ของ eXtensible Interface Streaming (AXIS) อย่างสมบูรณ์
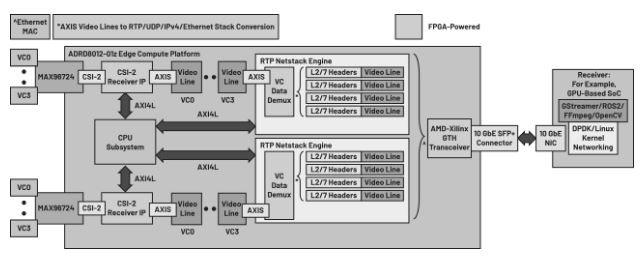
รูปที่ 7. ลำดับการสตรีมวิดีโอ RTP บน ADRD8012-01z

สรุป

บทความนี้แสดงให้เห็นว่าการส่งสัญญาณวิดีโอความเร็วสูงในพื้นที่ที่รองรับโดย GMSL สามารถปรับขนาดได้อย่างมีประสิทธิภาพไปสู่โครงสร้างพื้นฐานการสตรีมวิดีโอประสิทธิภาพสูง โดยยังคงรักษาประสิทธิภาพอัตราการส่งข้อมูลเท่าเดิมและให้พฤติกรรมที่มีความหน่วงต่ำ เพื่อนำสถาปัตยกรรมที่แข็งแกร่งและมีประสิทธิภาพนี้ไปใช้ จึงได้เลือกใช้อุปกรณ์ FPGA SoC อุปกรณ์ที่เลือกนี้มีทั้งทรัพยากร CPU และ FPGA ซึ่งรวมความสามารถทั้งด้านซอฟต์แวร์และฮาร์ดแวร์เข้าด้วยกันเพื่อสร้างเครื่องมือสตรีมวิดีโอแบบเรียลไทม์หลายกล้องที่มีประสิทธิภาพสูง
ผลิตภัณฑ์
September 30, 2026

การเชื่อมต่อระหว่าง GMSL และ Ethernet สำหรับการสตรีมวิดีโอจากกล้องหลายตัวที่มีประสิทธิภาพสูงและเป็นไปตามมาตรฐาน RFC

ค้นพบว่าการเชื่อมต่อระหว่าง GMSL และ Ethernet ช่วยปลดล็อกศักยภาพในการสตรีมวิดีโอจากกล้องหลายตัวด้วยความเร็วสูงและราบรื่นได้อย่างไร

นักเขียนบทความ
by 
นักเขียนบทความ
การเชื่อมต่อระหว่าง GMSL และ Ethernet สำหรับการสตรีมวิดีโอจากกล้องหลายตัวที่มีประสิทธิภาพสูงและเป็นไปตามมาตรฐาน RFC

การเชื่อมต่อระหว่าง GMSL และ Ethernet สำหรับการสตรีมวิดีโอจากกล้องหลายตัวที่มีประสิทธิภาพสูงและเป็นไปตามมาตรฐาน RFC

ค้นพบว่าการเชื่อมต่อระหว่าง GMSL และ Ethernet ช่วยปลดล็อกศักยภาพในการสตรีมวิดีโอจากกล้องหลายตัวด้วยความเร็วสูงและราบรื่นได้อย่างไร

บทความนี้เสนอวิธีการบูรณาการเทคโนโลยี Gigabit Multimedia Serial Link (GMSL) ™เข้ากับโดเมนอีเธอร์เน็ตได้อย่างราบรื่น เพื่อสร้างกระบวนการสตรีมมิ่งวิดีโอหลายกล้องความเร็วสูง ความหน่วงต่ำ และเป็นไปตามมาตรฐาน RFC อย่างสมบูรณ์ เพื่อให้ได้ประโยชน์จากประสิทธิภาพสูง ประหยัดพลังงาน และสถาปัตยกรรมที่ยืดหยุ่น กระบวนการสตรีมมิ่งวิดีโอความเร็วสูงทั้งหมดจึงถูกนำไปใช้โดยใช้ประโยชน์จากทรัพยากร FPGA

แนะนำ

ระบบอัตโนมัติทางอุตสาหกรรมผ่านหุ่นยนต์อัตโนมัติ1และการขับขี่อัตโนมัติ2ถือเป็นหนึ่งในเทคโนโลยีเกิดใหม่ที่สำคัญที่สุดของทศวรรษ 2020 หนึ่งในองค์ประกอบสำคัญของการใช้งานดังกล่าวคือการส่งสัญญาณวิดีโอ ซึ่งแสดงข้อมูลแบบเรียลไทม์เกี่ยวกับสภาพแวดล้อมของหุ่นยนต์หรือยานพาหนะ ด้วยวิธีนี้ เทคโนโลยี Gigabit Multimedia Serial Link (GMSL ™ ) มีบทบาทสำคัญในการให้ลิงก์วิดีโอความเร็วสูงที่มีประสิทธิภาพด้านต้นทุนผ่านสายไฟเส้นเดียวระหว่างโมดูลกล้องหลายตัว และเกี่ยวข้องกับการประมวลผลเซิร์ฟเวอร์ระบบบนชิป (SoC) ในทางกลับกัน เนื่องจากอุปกรณ์ส่วนใหญ่ที่ใช้ในองค์ประกอบอัตโนมัติต่างๆ นั้นเชื่อมต่อกันเป็นเครือข่าย มาตรฐานอีเธอร์เน็ตจึงกลายเป็นวิธีการส่งข้อมูลที่สำคัญ ซึ่งแสดงให้เห็นถึงความหลากหลายของการใช้งานความเร็วสูง ดังนั้น เทคโนโลยีการสตรีมวิดีโอจึงมีบทบาทสำคัญในการรับประกันความเร็วและมาตรฐานการส่งพิกเซลของกล้องระหว่างโฮสต์ SoC และอุปกรณ์เครือข่ายอื่นๆ จากสภาพแวดล้อม แง่มุมที่สำคัญที่สุดที่พิจารณาสำหรับการสตรีมวิดีโอคือความเร็วสูงและความหน่วงต่ำ ด้วยวิธีนี้ อุปกรณ์ FPGA จึงเป็นตัวเลือกที่ดีที่สุดเนื่องจากมีความยืดหยุ่นในการประมวลผลแบบขนานและการใช้งาน บทความนี้อธิบายถึงประสิทธิภาพการส่งวิดีโอระดับสูงไปยังบริการแพ็กเก็ตเครือข่าย IP และการกระจายวิดีโอโดยใช้โปรโตคอลการขนส่งแบบเรียลไทม์ (RTP) ซึ่งสามารถทำได้โดยการใช้ทรัพยากร FPGA อย่างเต็มที่ เพื่อแสดงให้เห็นถึงแนวทางที่นำเสนอ จะใช้สถานการณ์การสตรีมวิดีโอหลายกล้อง GMSL บนแพลตฟอร์มการประมวลผลแบบ Edge Computing ADRD8012-01Z ที่มีประสิทธิภาพสูง ความหน่วงต่ำ และคุ้มค่าเป็นตัวอย่าง

เทคโนโลยี GMSL และข้อกำหนด RTP

เทคโนโลยี GMSL ของ ADI เป็นโซลูชัน SERDES ที่ปรับขนาดได้และคุ้มค่า ออกแบบมาเพื่อส่งข้อมูลวิดีโอแบบเรียลไทม์ ข้อมูลควบคุม และพลังงานผ่านสายเคเบิลเพียงเส้นเดียว มีสถาปัตยกรรมสองแบบ: แบบหนึ่งสำหรับการเชื่อมต่อแบบอนุกรมที่มีความน่าเชื่อถือสูงระหว่างโมดูลกล้องและระบบ SoC แบบฝังตัว และอีกแบบหนึ่งระหว่าง SoC แบบฝังตัวและอุปกรณ์แสดงผล เทคโนโลยี GMSL ที่ใช้กล้องนั้นถูกนำไปใช้อย่างแพร่หลายในภาคยานยนต์ และปัจจุบันมีบทบาทสำคัญในการขับขี่อัตโนมัติ โดยให้การเชื่อมต่อวิดีโอความเร็วสูงที่มีประสิทธิภาพจากหลายส่วนของยานพาหนะโดยใช้สายเคเบิลให้น้อยที่สุด ยิ่งไปกว่านั้น ยังมีประโยชน์ในแอปพลิเคชันต่างๆ จากตลาดหุ่นยนต์ อุตสาหกรรม เครื่องมือวัด และการดูแลสุขภาพอีกด้วย

เพื่อให้สามารถส่งข้อมูลด้วยสายเดี่ยวตามที่กล่าวมาข้างต้น จึงได้มีการนำเทคโนโลยี SERDES ประสิทธิภาพสูงมาใช้ ซึ่งประกอบด้วยส่วนประกอบหลักสองส่วน ได้แก่ ตัวแปลงอนุกรม GMSL และตัวแปลงลำดับ GMSL ในบริบทของกล้อง ตัวแปลงอนุกรมจะแปลงข้อมูลวิดีโอแบบขนานความเร็วสูงที่มาจากอินเทอร์เฟซอนุกรมกล้องเวอร์ชัน 2 (CSI-2) ไปยังอินเทอร์เฟซเอาต์พุตของกล้อง ส่วนประกอบถัดไปในกลไกการส่งข้อมูล GMSL คือลิงก์อนุกรมความเร็วสูง ซึ่งมีความเร็วสูงสุดถึง 3 Gbps ใน GMSL1 สูงสุด 6 Gbps ใน GMSL2 และสูงสุด 12 Gbps ใน GMSL3 โดยใช้สายโคแอกเซียลหรือสายคู่บิดเกลียวหุ้มฉนวน (STP) สุดท้าย ตัวแปลงลำดับจะคลายการบีบอัดข้อมูลที่มาจากอุปกรณ์อนุกรมหลายตัว แล้วแปลงข้อมูลนั้นไปยังอินเทอร์เฟซเอาต์พุต CSI-2 หนึ่งตัวหรือมากกว่า เพื่อให้สามารถส่งข้อมูลแบบแบ่งเวลาได้ อุปกรณ์ GMSL จะใช้คุณสมบัติช่องสัญญาณเสมือนที่เสนอไว้ในข้อกำหนด MIPI CSI-2 ตัวระบุช่องสัญญาณเสมือนแสดงถึงกลไกการสลับข้อมูลแบบง่าย ๆ ที่ช่วยให้ตัวรับสามารถตีความเฟรมที่ได้รับจากแหล่งวิดีโอหลายแหล่งได้อย่างง่ายดายโดยใช้ค่า ID ที่กำหนดไว้

ภาพที่ 1 แสดงการเชื่อมต่อทั่วไประหว่างกล้องที่รองรับ GMSL จำนวน 4 ตัวกับวงจรรับสัญญาณ CSI-2 ที่รวมอยู่ในพื้นที่ FPGA ของ Xilinx SoC โดยใช้ตัวรับสัญญาณ CSI-2 และตัวควบคุม I2C เพื่อจัดการทั้งข้อมูลวิดีโอและการควบคุม

รูปที่ 1. ลำดับการส่งข้อมูล GMSL CSI-2 ไปยัง FPGA โดยใช้ MAX96724

RTP 4เป็นข้อกำหนดที่ใช้กันทั่วไปสำหรับการสตรีมวิดีโอผ่านเครือข่าย IP โดยทั่วไปจะใช้กลไกการขนส่งแบบไม่ต้องเชื่อมต่อที่มีความหน่วงต่ำโดยใช้ User Datagram Protocol (UDP) 5และกำหนดรูปแบบแพ็กเก็ตหลายแบบเพื่อรวมรูปแบบเพย์โหลดวิดีโอต่างๆ รูปที่ 2 แสดงแพ็กเก็ต RTP ทั่วไปสำหรับวิดีโอที่ไม่ได้บีบอัด 6ซึ่งมีส่วนหัว RTP ทั่วไป ส่วนหัวเพย์โหลด และบรรทัดสตรีมวิดีโอเฉพาะหลายบรรทัด ไม่ว่าจะเป็นบางส่วนหรือทั้งหมด เนื่องจากโปรโตคอล RTP ทำหน้าที่เป็นการใช้งานในเลเยอร์แอปพลิเคชัน จึงมีฟิลด์ที่จำเป็นทั้งหมดที่สามารถกำหนดลักษณะของข้อมูลเพย์โหลดได้อย่างละเอียด ในกรณีนี้ ฟิลด์สตรีม ประเภทวิดีโอ หรือเฟรมสุดท้ายเป็นฟิลด์เฉพาะแอปพลิเคชันหลายฟิลด์

รูปที่ 2 รูปแบบแพ็กเก็ต RTP

สแต็กเครือข่ายแบบไม่เชื่อมต่อจะใช้ FPGA แทนระบบย่อย CPU

เมื่อเทคโนโลยีระบบอัตโนมัติพัฒนาขึ้นในช่วงทศวรรษ 2020 ความต้องการโซลูชันที่เป็นนวัตกรรมใหม่ก็เพิ่มขึ้นอย่างมากในหลายตลาด เช่น การขับขี่อัตโนมัติ หรือระบบอัตโนมัติทางอุตสาหกรรมผ่านหุ่นยนต์ นอกจากการใช้เครือข่ายเซ็นเซอร์ที่หลากหลายและอัลกอริธึม AI ที่ซับซ้อนแล้ว การสตรีมวิดีโอความเร็วสูงและมีความหน่วงต่ำก็มีบทบาทสำคัญอย่างยิ่งเมื่อพูดถึงการขับขี่อัตโนมัติหรือหุ่นยนต์อัจฉริยะ เช่น หุ่นยนต์ฮิวมานอยด์ ในกรณีนี้ การส่งข้อมูลวิดีโอแบบเรียลไทม์ถือเป็นสิ่งสำคัญที่สุดที่ต้องพิจารณา หรือนำไปสู่ความจำเป็นในการพึ่งพาวิธีการส่งข้อมูลแบบไร้การเชื่อมต่อ คุณสมบัติ RTP ที่กล่าวถึงข้างต้นเป็นเสาหลักสำคัญเมื่อพูดถึงการใช้งานการสตรีมวิดีโอแบบเรียลไทม์ ซึ่งออกแบบมาโดยคำนึงถึงข้อกำหนดการส่งข้อมูล UDP และผ่านเครือข่าย IP เป็นหลัก

แม้ว่าการสตรีมวิดีโอแบบไร้การเชื่อมต่อจะส่งผลให้มีการใช้ทรัพยากรน้อยลงและมีประสิทธิภาพสูงกว่าเมื่อเทียบกับการออกแบบที่เน้นการเชื่อมต่อโดยใช้สแต็ก TCP/IP แต่ก็ยังสามารถปรับปรุงให้ดียิ่งขึ้นได้ เนื่องจากในบริบทของยานยนต์และอุตสาหกรรม การสตรีมวิดีโอส่วนใหญ่มักทำระหว่างระบบฝังตัวที่มีการเชื่อมต่อฮาร์ดแวร์ (HW) โดยตรงกับแหล่งวิดีโอ การปรับปรุงนี้สามารถทำได้โดยการใช้โซลูชันฮาร์ดแวร์ต่างๆ เช่น ระบบย่อย CPU ประสิทธิภาพสูงที่ใช้ในศูนย์ข้อมูล แม้ว่าอุปกรณ์ประมวลผลเหล่านี้จะสามารถแก้ไขช่องว่างด้านประสิทธิภาพในกระบวนการสตรีมวิดีโอทั่วไปได้ แต่ต้นทุนและความซับซ้อนทำให้ไม่เหมาะสมกับสภาพแวดล้อม SoC แบบฝังตัว ซึ่งต้องการส่วนประกอบที่ได้รับการปรับให้เหมาะสมทั้งด้านประสิทธิภาพและการประหยัดพลังงาน นอกจากนี้ อุปกรณ์ GPU ยังเป็นทางเลือกหนึ่งสำหรับการประมวลผลประสิทธิภาพสูง โดยใช้ประโยชน์จากการทำงานแบบขนานจำนวนมาก แต่มีความยืดหยุ่นในระดับฮาร์ดแวร์น้อยกว่า

ด้วยเหตุนี้ FPGA ที่สามารถกำหนดค่าใหม่ได้อย่างมากจึงกลายเป็นส่วนประกอบสำคัญเมื่อพูดถึงเครือข่ายประสิทธิภาพสูงและการสตรีมวิดีโอแบบเรียลไทม์ เพื่อเพิ่มประสิทธิภาพการประมวลผลแบบ Edge Computing ให้สูงสุด SoC แบบฝังตัวในปัจจุบันจึงรวมระบบย่อย CPU ทรัพยากร FPGA และ RAM ไว้ในชิปเดียว ดังนั้น อุปกรณ์ประเภทนี้จึงสามารถเป็นตัวเลือกการประมวลผลที่ดีที่สุดสำหรับการสตรีมวิดีโอแบบเรียลไทม์ สามารถรับข้อมูลวิดีโอ แปลงพิกเซลวิดีโอที่ได้รับเป็นแพ็กเก็ตเครือข่าย และสตรีมวิดีโอโดยใช้การประมวลผล CPU น้อยที่สุด ซึ่งใช้สำหรับการกำหนดค่าฟิลด์โปรโตคอล ดังนั้น การแปลงข้อมูลวิดีโอเป็นแพ็กเก็ตเครือข่ายอย่างสมบูรณ์และการสตรีมวิดีโอแบบไร้การเชื่อมต่อจึงสามารถทำได้โดยให้ประสิทธิภาพสูงสุดทั้งในแง่ของความหน่วงและอัตราข้อมูล แม้ว่าจะใช้โมดูลกล้องหนึ่งตัวหรือมากกว่าก็ตาม เพื่อให้ได้ประสิทธิภาพการส่งข้อมูลที่ดีที่สุดและความเหมาะสมกับทรัพยากร FPGA ที่มีอยู่ การออกแบบสถาปัตยกรรมสแต็กเครือข่ายนี้จึงมีโปรโตคอลเลเยอร์แอปพลิเคชัน (RFC) ที่สอดคล้องกับข้อกำหนดอย่างสมบูรณ์ และการออกแบบที่ควบคุมด้วยซอฟต์แวร์ (SW) น้อยที่สุดสำหรับข้อกำหนดเลเยอร์การขนส่ง เครือข่าย และลิงก์ข้อมูล ซึ่งจะแทนที่การใช้งานการกำหนดเส้นทาง IP แบบดั้งเดิมด้วยการกำหนดค่าฟิลด์ด้วยตนเองที่ง่ายขึ้นสำหรับการกำหนดที่อยู่ IP

แปลงชื่อโดเมนวิดีโอให้เข้ากับเครือข่าย

ดังที่กล่าวไว้ก่อนหน้านี้ เทคโนโลยี GMSL มีเป้าหมายในการแปลงข้อมูลวิดีโอที่มาจากโมดูลกล้องหลายตัวให้เป็นข้อมูลอนุกรม แล้วส่งออกสตรีมที่เชื่อมต่อกันผ่านการใช้งานมาตรฐาน เช่น CSI-2 ไปยัง SoC แบบฝังตัว เพื่อให้บรรลุการเชื่อมต่อนี้ เทคโนโลยีนี้ใช้กลไกช่องสัญญาณเสมือนแบบสลับกัน โดยใช้ความสามารถในการจัดเก็บข้อมูลที่มีอยู่ในอุปกรณ์ GMSL SERDES บทความนี้อธิบายถึงเส้นทางวิดีโอประสิทธิภาพสูง ความหน่วงต่ำ และไม่บีบอัด สำหรับการแปลงเป็นแพ็กเก็ตเครือข่าย IP เลือกใช้สแต็กการสตรีมวิดีโอแบบ RTP มาตรฐาน เนื่องจากมีการออกแบบส่วนหัวที่น้อยที่สุดและตัวเลือกเลเยอร์การขนส่งแบบไร้การเชื่อมต่อโดยใช้ UDP ด้วยวิธีการดังกล่าว สแต็กการสตรีมวิดีโอจึงเข้ากันได้กับการใช้งานซอฟต์แวร์หรือฮาร์ดแวร์ฝั่งรับอื่นๆ มากมาย และเป็นไปตามมาตรฐาน RTP RFC อย่างสมบูรณ์

แม้ว่าข้อกำหนด RTP สำหรับวิดีโอที่ไม่บีบอัดจะรวมถึงสถาปัตยกรรมที่มีสตรีมแบบแบ่งส่วน แต่แนวทางที่ดีที่สุดในการนำไปใช้เพื่อรองรับฮาร์ดแวร์คือการออกแบบที่ไม่แบ่งส่วน ซึ่งจะช่วยลดการใช้ทรัพยากรลงอย่างมาก พร้อมทั้งลดการใช้พลังงานให้น้อยที่สุด

ดังที่ได้กล่าวไปแล้ว มีอุปกรณ์ประมวลผลหลายชนิดที่สามารถแปลงสัญญาณวิดีโอเป็นสัญญาณเครือข่ายได้ นอกจากนี้ยังมีวิธีการส่งข้อมูลหลายวิธี รูปที่ 3, 4 และ 5 แสดงให้เห็นถึงความสามารถในการส่งข้อมูลผ่านหน่วยความจำโดยใช้ระบบฝังตัวที่ใช้ CPU/GPU/FPGA และสถาปัตยกรรมสแต็กการสตรีมวิดีโอแบบ FPGA เพียงอย่างเดียวที่กล่าวถึงในบทความนี้

รูปที่ 3 แสดงตัวเลือกที่สามารถเลือกได้เมื่อใช้งานสแต็กเครือข่ายที่เกี่ยวข้องกับการสตรีมวิดีโอโดยอิงตามการออกแบบร่วม HW/SW แบบคลาสสิก ดังนั้น ด้านซ้ายประกอบด้วยระบบย่อยตัวรับวิดีโอ ซึ่งจะส่งสตรีมวิดีโอไปยัง RAM ของระบบฝังตัวโดยใช้ตัวควบคุมการเข้าถึงหน่วยความจำโดยตรง (DMA) จากนั้นข้อมูลวิดีโอจะถูกอ่านจากหน่วยความจำและส่งไปยังตัวควบคุมการเข้าถึงสื่ออีเธอร์เน็ต (MAC) โดยใช้กลไกการออกแบบสแต็กเครือข่ายอย่างใดอย่างหนึ่งต่อไปนี้: (1) ชุดพัฒนา Data Plane (DPDK) 7หรือ (2) การใช้งานเครือข่ายแบบดั้งเดิมที่ใช้เคอร์เนล Linux 8สุดท้ายแล้ว Ethernet MAC จะส่งต่อแพ็กเก็ตเครือข่ายไปยัง Ethernet PHY ที่เชื่อมต่ออยู่

รูปที่ 3. การสตรีมวิดีโอแบบคลาสสิกโดยใช้หน่วยความจำ

ภาพที่ 4 แสดงให้เห็นถึงวิธีการใช้งานลำดับการส่งข้อมูลโดยใช้การเข้าถึงหน่วยความจำโดยตรงระยะไกล (RDMA) โดยแสดงให้เห็นถึงความจำเป็นในการใช้การ์ดอินเทอร์เฟซเครือข่าย (NIC) ที่รองรับ RDMA สำหรับทั้งฝั่งผู้ส่งและผู้รับ ดังที่แสดงในแผนภาพ การใช้งานเลเยอร์ 2 พื้นฐานนั้นอิงตามมาตรฐานอีเธอร์เน็ต ลำดับตัวอย่างนี้เป็นภาพรวมที่แสดงให้เห็นถึงวิธีการใช้งานการส่งข้อมูล RDMA ผ่านอีเธอร์เน็ตคอนเวอร์เจนซ์ (RoCE)

รูปที่ 4 การส่งสัญญาณวิดีโอโดยใช้ RDMA

ภาพที่ 5 นำเสนอภาพรวมของแนวทางในบทความนี้ โดยเผยให้เห็นส่วนประกอบที่สำคัญที่สุด ได้แก่ การแปลงเส้นทางวิดีโอที่ใช้ FPGA ไปเป็นแพ็กเก็ต RTP และโมดูลสแต็กเครือข่ายแบบไร้การเชื่อมต่อ

รูปที่ 5. เครื่องมือสตรีมมิ่งวิดีโอที่เร่งความเร็วด้วย FPGA

ภาพที่ 6 แสดงการแปลงข้อมูลวิดีโอ CSI-2 ไปเป็นการแปลงแพ็กเก็ต RTP อย่างสมบูรณ์ เพื่อประสิทธิภาพในการออกแบบการแปลง จึงเลือกการแปลงแบบ 1 บรรทัดเป็น 1 แพ็กเก็ต RTP ซึ่งเป็นวิธีที่ดีที่สุดทั้งในแง่ของการใช้ทรัพยากรและมาตรฐานอีเธอร์เน็ต เฟรมอีเธอร์เน็ตทั่วไปที่อิงตามหน่วยการส่งข้อมูลสูงสุด (MTU) ซึ่งเป็นหน่วยวัดที่ใช้ใน NIC ที่ผลิตจริง มีช่วง 1500 (ปกติ) หรือ 9000 (เฟรมจัมโบ้) และค่าสูงสุดทางทฤษฎี 65536 (เฟรมขนาดใหญ่พิเศษ) สำหรับกรณีการใช้งานทดลอง เนื่องจากวิดีโอหนึ่งบรรทัดแสดงถึงหลายพันไบต์ จึงเลือกสถาปัตยกรรมแบบ 1 บรรทัดเพื่อให้สอดคล้องกับการออกแบบ NIC ของตัวรับส่วนใหญ่ ดังที่ได้กล่าวไว้ก่อนหน้านี้ การแปลงข้อมูลวิดีโอเป็นแพ็กเก็ต RTP แบบซอฟต์แวร์อย่างเดียวหรือแบบฮาร์ดแวร์/ซอฟต์แวร์นั้นเกี่ยวข้องกับการอ่าน/เขียนหน่วยความจำจำนวนมากทั้งในระบบย่อยซอฟต์แวร์วิดีโอและเครือข่าย ซึ่งเพิ่มความซับซ้อนและลดประสิทธิภาพลงเนื่องจากความหน่วงสูง ในแนวทางฮาร์ดแวร์แบบเต็มรูปแบบนี้ ความซับซ้อนของการใช้งานจะลดลงเหลือน้อยที่สุด โดยมีกลไกการจัดเก็บข้อมูลเพียงอย่างเดียวสำหรับช่วงเวลาการส่งข้อมูลของแต่ละเส้นทาง จึงมั่นใจได้ว่าแพ็กเก็ตที่ส่งผ่านสายเคเบิลจะไม่ถูกแบ่งส่วน ในทางกลับกัน กลไกที่เรียบง่ายอย่างยิ่งนี้มีประโยชน์เฉพาะสำหรับการแปลงข้อมูลจากกลุ่มสตรีมวิดีโอที่แบ่งเวลาโดยใช้ความสามารถของช่องสัญญาณเสมือนเท่านั้น ในกรณีที่ใช้กลุ่มสตรีมวิดีโอที่แบ่งเวลาหลายกลุ่มแบบขนานกัน จำเป็นต้องเพิ่มระดับการจัดเก็บข้อมูลใหม่ลงในลำดับชั้นการส่งข้อมูล ซึ่งจะสร้างเส้นทางที่แบ่งเวลาไปยังระบบย่อยเครือข่าย

รูปที่ 6 การแปลงพิกเซลวิดีโอ (หนึ่งบรรทัด) เป็นแพ็กเก็ต RTP

ดังแสดงในรูปที่ 6 กระบวนการแปลประกอบด้วยสองขั้นตอน: (1) รวบรวมข้อมูลจากการใช้งานตัวรับ CSI-2 และสร้างแพ็กเก็ตตามสตรีมวิดีโอที่สอดคล้องกับ AXIS และ (2) สร้างแพ็กเก็ต RTP โดยการเพิ่มส่วนหัวโปรโตคอลลงในสตรีมวิดีโอ

แพลตฟอร์มการประมวลผลแบบ Edge Computing ADI GMSL ไปยัง 10 GbE

เพื่อใช้ประโยชน์จากข้อดีของการออกแบบการสตรีมวิดีโอ RTP ที่เร่งความเร็วด้วย FPGA อย่างเต็มรูปแบบ ADI จึงนำเสนอแพลตฟอร์มการประมวลผลแบบ Edge Computing รุ่น ADRD8012-01Z ซึ่งเป็นตัวแปลงสัญญาณ GMSL หลายกล้องประสิทธิภาพสูงเป็น 10 Gigabit Ethernet (GbE) ที่สร้างขึ้นบน AMD-Xilinx K26 SoM ที่คุ้มค่า ฮาร์ดแวร์ประกอบด้วยตัวแปลงสัญญาณอนุกรม MAX96724 สองตัวที่มี 4GMS ซึ่งสามารถรองรับสตรีมวิดีโอแบบขนานได้สูงสุด 8 กล้อง โดยแสดงเป็น 2 บล็อกของ 4 ช่องสัญญาณเสมือน (VC - VC0 ถึง VC3) ก่อนตัวแปลงสัญญาณอนุกรม ภาพที่ 7 แสดงลำดับการสตรีมวิดีโอทั้งหมด ในแง่ของเครือข่าย แพลตฟอร์มนี้มีขั้วต่อแบบเสียบได้ (SFP+) ที่สามารถใช้เพื่อส่งข้อมูลผ่านเครือข่าย 10 GbE ได้ โมดูลกล้องที่ทดสอบกับการใช้งานการสตรีมวิดีโอของผลิตภัณฑ์นี้มีดังนี้: กล้องระดับยานยนต์ C1 และ C2 คลาส IV ที่มีช่วงไดนามิกสูงถึง 120 dB และความละเอียด 2.5 MP/5.4 MP และ Intel RealSense D457 นอกจากนี้ โมดูลยังประกอบด้วยตัวประมวลผลภาพ (ISP) ในตัวที่เชื่อมต่อกับเซ็นเซอร์ภาพแต่ละตัว ทำให้สามารถส่งภาพสีเต็มรูปแบบตามข้อกำหนด YUV422 ได้ ตัวอย่างเช่น ดังที่กล่าวไว้ก่อนหน้านี้ ในบริบทของการสตรีมวิดีโอ ข้อกำหนดของเลเยอร์แอปพลิเคชันทำหน้าที่เป็นพื้นฐานสำหรับการแสดงโครงสร้างของเฟรม ในกรณีนี้ สำหรับการส่งวิดีโอแบบไม่บีบอัด ส่วนหัวของเพย์โหลด RTP 6จะกำหนดความยาวของแต่ละฟิลด์เพย์โหลด ซึ่งระบุความยาวบรรทัดจริง จำนวนบรรทัด และปัจจัยอื่นๆ ที่เกี่ยวข้องกับการแบ่งส่วนซึ่งไม่ได้พิจารณาในแนวทางของเอกสารนี้ ในทางกลับกัน ส่วนหัว RTP ทั่วไป4แสดงประเภทวิดีโอและค่าตัวระบุเครื่องหมาย โดยระบุไบต์สุดท้ายของเฟรมวิดีโอ ซึ่งตรงกับส่วนตรรกะ TVALID/TLAST ของ eXtensible Interface Streaming (AXIS) อย่างสมบูรณ์

รูปที่ 7. ลำดับการสตรีมวิดีโอ RTP บน ADRD8012-01z

สรุป

บทความนี้แสดงให้เห็นว่าการส่งสัญญาณวิดีโอความเร็วสูงในพื้นที่ที่รองรับโดย GMSL สามารถปรับขนาดได้อย่างมีประสิทธิภาพไปสู่โครงสร้างพื้นฐานการสตรีมวิดีโอประสิทธิภาพสูง โดยยังคงรักษาประสิทธิภาพอัตราการส่งข้อมูลเท่าเดิมและให้พฤติกรรมที่มีความหน่วงต่ำ เพื่อนำสถาปัตยกรรมที่แข็งแกร่งและมีประสิทธิภาพนี้ไปใช้ จึงได้เลือกใช้อุปกรณ์ FPGA SoC อุปกรณ์ที่เลือกนี้มีทั้งทรัพยากร CPU และ FPGA ซึ่งรวมความสามารถทั้งด้านซอฟต์แวร์และฮาร์ดแวร์เข้าด้วยกันเพื่อสร้างเครื่องมือสตรีมวิดีโอแบบเรียลไทม์หลายกล้องที่มีประสิทธิภาพสูง
Lorem ipsum dolor sit amet, consectetur adipiscing elit. Suspendisse varius enim in eros elementum tristique. Duis cursus, mi quis viverra ornare, eros dolor interdum nulla, ut commodo diam libero vitae erat. Aenean faucibus nibh et justo cursus id rutrum lorem imperdiet. Nunc ut sem vitae risus tristique posuere.

การเชื่อมต่อระหว่าง GMSL และ Ethernet สำหรับการสตรีมวิดีโอจากกล้องหลายตัวที่มีประสิทธิภาพสูงและเป็นไปตามมาตรฐาน RFC

การเชื่อมต่อระหว่าง GMSL และ Ethernet สำหรับการสตรีมวิดีโอจากกล้องหลายตัวที่มีประสิทธิภาพสูงและเป็นไปตามมาตรฐาน RFC

ค้นพบว่าการเชื่อมต่อระหว่าง GMSL และ Ethernet ช่วยปลดล็อกศักยภาพในการสตรีมวิดีโอจากกล้องหลายตัวด้วยความเร็วสูงและราบรื่นได้อย่างไร

Lorem ipsum dolor amet consectetur adipiscing elit tortor massa arcu non.

บทความนี้เสนอวิธีการบูรณาการเทคโนโลยี Gigabit Multimedia Serial Link (GMSL) ™เข้ากับโดเมนอีเธอร์เน็ตได้อย่างราบรื่น เพื่อสร้างกระบวนการสตรีมมิ่งวิดีโอหลายกล้องความเร็วสูง ความหน่วงต่ำ และเป็นไปตามมาตรฐาน RFC อย่างสมบูรณ์ เพื่อให้ได้ประโยชน์จากประสิทธิภาพสูง ประหยัดพลังงาน และสถาปัตยกรรมที่ยืดหยุ่น กระบวนการสตรีมมิ่งวิดีโอความเร็วสูงทั้งหมดจึงถูกนำไปใช้โดยใช้ประโยชน์จากทรัพยากร FPGA

แนะนำ

ระบบอัตโนมัติทางอุตสาหกรรมผ่านหุ่นยนต์อัตโนมัติ1และการขับขี่อัตโนมัติ2ถือเป็นหนึ่งในเทคโนโลยีเกิดใหม่ที่สำคัญที่สุดของทศวรรษ 2020 หนึ่งในองค์ประกอบสำคัญของการใช้งานดังกล่าวคือการส่งสัญญาณวิดีโอ ซึ่งแสดงข้อมูลแบบเรียลไทม์เกี่ยวกับสภาพแวดล้อมของหุ่นยนต์หรือยานพาหนะ ด้วยวิธีนี้ เทคโนโลยี Gigabit Multimedia Serial Link (GMSL ™ ) มีบทบาทสำคัญในการให้ลิงก์วิดีโอความเร็วสูงที่มีประสิทธิภาพด้านต้นทุนผ่านสายไฟเส้นเดียวระหว่างโมดูลกล้องหลายตัว และเกี่ยวข้องกับการประมวลผลเซิร์ฟเวอร์ระบบบนชิป (SoC) ในทางกลับกัน เนื่องจากอุปกรณ์ส่วนใหญ่ที่ใช้ในองค์ประกอบอัตโนมัติต่างๆ นั้นเชื่อมต่อกันเป็นเครือข่าย มาตรฐานอีเธอร์เน็ตจึงกลายเป็นวิธีการส่งข้อมูลที่สำคัญ ซึ่งแสดงให้เห็นถึงความหลากหลายของการใช้งานความเร็วสูง ดังนั้น เทคโนโลยีการสตรีมวิดีโอจึงมีบทบาทสำคัญในการรับประกันความเร็วและมาตรฐานการส่งพิกเซลของกล้องระหว่างโฮสต์ SoC และอุปกรณ์เครือข่ายอื่นๆ จากสภาพแวดล้อม แง่มุมที่สำคัญที่สุดที่พิจารณาสำหรับการสตรีมวิดีโอคือความเร็วสูงและความหน่วงต่ำ ด้วยวิธีนี้ อุปกรณ์ FPGA จึงเป็นตัวเลือกที่ดีที่สุดเนื่องจากมีความยืดหยุ่นในการประมวลผลแบบขนานและการใช้งาน บทความนี้อธิบายถึงประสิทธิภาพการส่งวิดีโอระดับสูงไปยังบริการแพ็กเก็ตเครือข่าย IP และการกระจายวิดีโอโดยใช้โปรโตคอลการขนส่งแบบเรียลไทม์ (RTP) ซึ่งสามารถทำได้โดยการใช้ทรัพยากร FPGA อย่างเต็มที่ เพื่อแสดงให้เห็นถึงแนวทางที่นำเสนอ จะใช้สถานการณ์การสตรีมวิดีโอหลายกล้อง GMSL บนแพลตฟอร์มการประมวลผลแบบ Edge Computing ADRD8012-01Z ที่มีประสิทธิภาพสูง ความหน่วงต่ำ และคุ้มค่าเป็นตัวอย่าง

เทคโนโลยี GMSL และข้อกำหนด RTP

เทคโนโลยี GMSL ของ ADI เป็นโซลูชัน SERDES ที่ปรับขนาดได้และคุ้มค่า ออกแบบมาเพื่อส่งข้อมูลวิดีโอแบบเรียลไทม์ ข้อมูลควบคุม และพลังงานผ่านสายเคเบิลเพียงเส้นเดียว มีสถาปัตยกรรมสองแบบ: แบบหนึ่งสำหรับการเชื่อมต่อแบบอนุกรมที่มีความน่าเชื่อถือสูงระหว่างโมดูลกล้องและระบบ SoC แบบฝังตัว และอีกแบบหนึ่งระหว่าง SoC แบบฝังตัวและอุปกรณ์แสดงผล เทคโนโลยี GMSL ที่ใช้กล้องนั้นถูกนำไปใช้อย่างแพร่หลายในภาคยานยนต์ และปัจจุบันมีบทบาทสำคัญในการขับขี่อัตโนมัติ โดยให้การเชื่อมต่อวิดีโอความเร็วสูงที่มีประสิทธิภาพจากหลายส่วนของยานพาหนะโดยใช้สายเคเบิลให้น้อยที่สุด ยิ่งไปกว่านั้น ยังมีประโยชน์ในแอปพลิเคชันต่างๆ จากตลาดหุ่นยนต์ อุตสาหกรรม เครื่องมือวัด และการดูแลสุขภาพอีกด้วย

เพื่อให้สามารถส่งข้อมูลด้วยสายเดี่ยวตามที่กล่าวมาข้างต้น จึงได้มีการนำเทคโนโลยี SERDES ประสิทธิภาพสูงมาใช้ ซึ่งประกอบด้วยส่วนประกอบหลักสองส่วน ได้แก่ ตัวแปลงอนุกรม GMSL และตัวแปลงลำดับ GMSL ในบริบทของกล้อง ตัวแปลงอนุกรมจะแปลงข้อมูลวิดีโอแบบขนานความเร็วสูงที่มาจากอินเทอร์เฟซอนุกรมกล้องเวอร์ชัน 2 (CSI-2) ไปยังอินเทอร์เฟซเอาต์พุตของกล้อง ส่วนประกอบถัดไปในกลไกการส่งข้อมูล GMSL คือลิงก์อนุกรมความเร็วสูง ซึ่งมีความเร็วสูงสุดถึง 3 Gbps ใน GMSL1 สูงสุด 6 Gbps ใน GMSL2 และสูงสุด 12 Gbps ใน GMSL3 โดยใช้สายโคแอกเซียลหรือสายคู่บิดเกลียวหุ้มฉนวน (STP) สุดท้าย ตัวแปลงลำดับจะคลายการบีบอัดข้อมูลที่มาจากอุปกรณ์อนุกรมหลายตัว แล้วแปลงข้อมูลนั้นไปยังอินเทอร์เฟซเอาต์พุต CSI-2 หนึ่งตัวหรือมากกว่า เพื่อให้สามารถส่งข้อมูลแบบแบ่งเวลาได้ อุปกรณ์ GMSL จะใช้คุณสมบัติช่องสัญญาณเสมือนที่เสนอไว้ในข้อกำหนด MIPI CSI-2 ตัวระบุช่องสัญญาณเสมือนแสดงถึงกลไกการสลับข้อมูลแบบง่าย ๆ ที่ช่วยให้ตัวรับสามารถตีความเฟรมที่ได้รับจากแหล่งวิดีโอหลายแหล่งได้อย่างง่ายดายโดยใช้ค่า ID ที่กำหนดไว้

ภาพที่ 1 แสดงการเชื่อมต่อทั่วไประหว่างกล้องที่รองรับ GMSL จำนวน 4 ตัวกับวงจรรับสัญญาณ CSI-2 ที่รวมอยู่ในพื้นที่ FPGA ของ Xilinx SoC โดยใช้ตัวรับสัญญาณ CSI-2 และตัวควบคุม I2C เพื่อจัดการทั้งข้อมูลวิดีโอและการควบคุม

รูปที่ 1. ลำดับการส่งข้อมูล GMSL CSI-2 ไปยัง FPGA โดยใช้ MAX96724

RTP 4เป็นข้อกำหนดที่ใช้กันทั่วไปสำหรับการสตรีมวิดีโอผ่านเครือข่าย IP โดยทั่วไปจะใช้กลไกการขนส่งแบบไม่ต้องเชื่อมต่อที่มีความหน่วงต่ำโดยใช้ User Datagram Protocol (UDP) 5และกำหนดรูปแบบแพ็กเก็ตหลายแบบเพื่อรวมรูปแบบเพย์โหลดวิดีโอต่างๆ รูปที่ 2 แสดงแพ็กเก็ต RTP ทั่วไปสำหรับวิดีโอที่ไม่ได้บีบอัด 6ซึ่งมีส่วนหัว RTP ทั่วไป ส่วนหัวเพย์โหลด และบรรทัดสตรีมวิดีโอเฉพาะหลายบรรทัด ไม่ว่าจะเป็นบางส่วนหรือทั้งหมด เนื่องจากโปรโตคอล RTP ทำหน้าที่เป็นการใช้งานในเลเยอร์แอปพลิเคชัน จึงมีฟิลด์ที่จำเป็นทั้งหมดที่สามารถกำหนดลักษณะของข้อมูลเพย์โหลดได้อย่างละเอียด ในกรณีนี้ ฟิลด์สตรีม ประเภทวิดีโอ หรือเฟรมสุดท้ายเป็นฟิลด์เฉพาะแอปพลิเคชันหลายฟิลด์

รูปที่ 2 รูปแบบแพ็กเก็ต RTP

สแต็กเครือข่ายแบบไม่เชื่อมต่อจะใช้ FPGA แทนระบบย่อย CPU

เมื่อเทคโนโลยีระบบอัตโนมัติพัฒนาขึ้นในช่วงทศวรรษ 2020 ความต้องการโซลูชันที่เป็นนวัตกรรมใหม่ก็เพิ่มขึ้นอย่างมากในหลายตลาด เช่น การขับขี่อัตโนมัติ หรือระบบอัตโนมัติทางอุตสาหกรรมผ่านหุ่นยนต์ นอกจากการใช้เครือข่ายเซ็นเซอร์ที่หลากหลายและอัลกอริธึม AI ที่ซับซ้อนแล้ว การสตรีมวิดีโอความเร็วสูงและมีความหน่วงต่ำก็มีบทบาทสำคัญอย่างยิ่งเมื่อพูดถึงการขับขี่อัตโนมัติหรือหุ่นยนต์อัจฉริยะ เช่น หุ่นยนต์ฮิวมานอยด์ ในกรณีนี้ การส่งข้อมูลวิดีโอแบบเรียลไทม์ถือเป็นสิ่งสำคัญที่สุดที่ต้องพิจารณา หรือนำไปสู่ความจำเป็นในการพึ่งพาวิธีการส่งข้อมูลแบบไร้การเชื่อมต่อ คุณสมบัติ RTP ที่กล่าวถึงข้างต้นเป็นเสาหลักสำคัญเมื่อพูดถึงการใช้งานการสตรีมวิดีโอแบบเรียลไทม์ ซึ่งออกแบบมาโดยคำนึงถึงข้อกำหนดการส่งข้อมูล UDP และผ่านเครือข่าย IP เป็นหลัก

แม้ว่าการสตรีมวิดีโอแบบไร้การเชื่อมต่อจะส่งผลให้มีการใช้ทรัพยากรน้อยลงและมีประสิทธิภาพสูงกว่าเมื่อเทียบกับการออกแบบที่เน้นการเชื่อมต่อโดยใช้สแต็ก TCP/IP แต่ก็ยังสามารถปรับปรุงให้ดียิ่งขึ้นได้ เนื่องจากในบริบทของยานยนต์และอุตสาหกรรม การสตรีมวิดีโอส่วนใหญ่มักทำระหว่างระบบฝังตัวที่มีการเชื่อมต่อฮาร์ดแวร์ (HW) โดยตรงกับแหล่งวิดีโอ การปรับปรุงนี้สามารถทำได้โดยการใช้โซลูชันฮาร์ดแวร์ต่างๆ เช่น ระบบย่อย CPU ประสิทธิภาพสูงที่ใช้ในศูนย์ข้อมูล แม้ว่าอุปกรณ์ประมวลผลเหล่านี้จะสามารถแก้ไขช่องว่างด้านประสิทธิภาพในกระบวนการสตรีมวิดีโอทั่วไปได้ แต่ต้นทุนและความซับซ้อนทำให้ไม่เหมาะสมกับสภาพแวดล้อม SoC แบบฝังตัว ซึ่งต้องการส่วนประกอบที่ได้รับการปรับให้เหมาะสมทั้งด้านประสิทธิภาพและการประหยัดพลังงาน นอกจากนี้ อุปกรณ์ GPU ยังเป็นทางเลือกหนึ่งสำหรับการประมวลผลประสิทธิภาพสูง โดยใช้ประโยชน์จากการทำงานแบบขนานจำนวนมาก แต่มีความยืดหยุ่นในระดับฮาร์ดแวร์น้อยกว่า

ด้วยเหตุนี้ FPGA ที่สามารถกำหนดค่าใหม่ได้อย่างมากจึงกลายเป็นส่วนประกอบสำคัญเมื่อพูดถึงเครือข่ายประสิทธิภาพสูงและการสตรีมวิดีโอแบบเรียลไทม์ เพื่อเพิ่มประสิทธิภาพการประมวลผลแบบ Edge Computing ให้สูงสุด SoC แบบฝังตัวในปัจจุบันจึงรวมระบบย่อย CPU ทรัพยากร FPGA และ RAM ไว้ในชิปเดียว ดังนั้น อุปกรณ์ประเภทนี้จึงสามารถเป็นตัวเลือกการประมวลผลที่ดีที่สุดสำหรับการสตรีมวิดีโอแบบเรียลไทม์ สามารถรับข้อมูลวิดีโอ แปลงพิกเซลวิดีโอที่ได้รับเป็นแพ็กเก็ตเครือข่าย และสตรีมวิดีโอโดยใช้การประมวลผล CPU น้อยที่สุด ซึ่งใช้สำหรับการกำหนดค่าฟิลด์โปรโตคอล ดังนั้น การแปลงข้อมูลวิดีโอเป็นแพ็กเก็ตเครือข่ายอย่างสมบูรณ์และการสตรีมวิดีโอแบบไร้การเชื่อมต่อจึงสามารถทำได้โดยให้ประสิทธิภาพสูงสุดทั้งในแง่ของความหน่วงและอัตราข้อมูล แม้ว่าจะใช้โมดูลกล้องหนึ่งตัวหรือมากกว่าก็ตาม เพื่อให้ได้ประสิทธิภาพการส่งข้อมูลที่ดีที่สุดและความเหมาะสมกับทรัพยากร FPGA ที่มีอยู่ การออกแบบสถาปัตยกรรมสแต็กเครือข่ายนี้จึงมีโปรโตคอลเลเยอร์แอปพลิเคชัน (RFC) ที่สอดคล้องกับข้อกำหนดอย่างสมบูรณ์ และการออกแบบที่ควบคุมด้วยซอฟต์แวร์ (SW) น้อยที่สุดสำหรับข้อกำหนดเลเยอร์การขนส่ง เครือข่าย และลิงก์ข้อมูล ซึ่งจะแทนที่การใช้งานการกำหนดเส้นทาง IP แบบดั้งเดิมด้วยการกำหนดค่าฟิลด์ด้วยตนเองที่ง่ายขึ้นสำหรับการกำหนดที่อยู่ IP

แปลงชื่อโดเมนวิดีโอให้เข้ากับเครือข่าย

ดังที่กล่าวไว้ก่อนหน้านี้ เทคโนโลยี GMSL มีเป้าหมายในการแปลงข้อมูลวิดีโอที่มาจากโมดูลกล้องหลายตัวให้เป็นข้อมูลอนุกรม แล้วส่งออกสตรีมที่เชื่อมต่อกันผ่านการใช้งานมาตรฐาน เช่น CSI-2 ไปยัง SoC แบบฝังตัว เพื่อให้บรรลุการเชื่อมต่อนี้ เทคโนโลยีนี้ใช้กลไกช่องสัญญาณเสมือนแบบสลับกัน โดยใช้ความสามารถในการจัดเก็บข้อมูลที่มีอยู่ในอุปกรณ์ GMSL SERDES บทความนี้อธิบายถึงเส้นทางวิดีโอประสิทธิภาพสูง ความหน่วงต่ำ และไม่บีบอัด สำหรับการแปลงเป็นแพ็กเก็ตเครือข่าย IP เลือกใช้สแต็กการสตรีมวิดีโอแบบ RTP มาตรฐาน เนื่องจากมีการออกแบบส่วนหัวที่น้อยที่สุดและตัวเลือกเลเยอร์การขนส่งแบบไร้การเชื่อมต่อโดยใช้ UDP ด้วยวิธีการดังกล่าว สแต็กการสตรีมวิดีโอจึงเข้ากันได้กับการใช้งานซอฟต์แวร์หรือฮาร์ดแวร์ฝั่งรับอื่นๆ มากมาย และเป็นไปตามมาตรฐาน RTP RFC อย่างสมบูรณ์

แม้ว่าข้อกำหนด RTP สำหรับวิดีโอที่ไม่บีบอัดจะรวมถึงสถาปัตยกรรมที่มีสตรีมแบบแบ่งส่วน แต่แนวทางที่ดีที่สุดในการนำไปใช้เพื่อรองรับฮาร์ดแวร์คือการออกแบบที่ไม่แบ่งส่วน ซึ่งจะช่วยลดการใช้ทรัพยากรลงอย่างมาก พร้อมทั้งลดการใช้พลังงานให้น้อยที่สุด

ดังที่ได้กล่าวไปแล้ว มีอุปกรณ์ประมวลผลหลายชนิดที่สามารถแปลงสัญญาณวิดีโอเป็นสัญญาณเครือข่ายได้ นอกจากนี้ยังมีวิธีการส่งข้อมูลหลายวิธี รูปที่ 3, 4 และ 5 แสดงให้เห็นถึงความสามารถในการส่งข้อมูลผ่านหน่วยความจำโดยใช้ระบบฝังตัวที่ใช้ CPU/GPU/FPGA และสถาปัตยกรรมสแต็กการสตรีมวิดีโอแบบ FPGA เพียงอย่างเดียวที่กล่าวถึงในบทความนี้

รูปที่ 3 แสดงตัวเลือกที่สามารถเลือกได้เมื่อใช้งานสแต็กเครือข่ายที่เกี่ยวข้องกับการสตรีมวิดีโอโดยอิงตามการออกแบบร่วม HW/SW แบบคลาสสิก ดังนั้น ด้านซ้ายประกอบด้วยระบบย่อยตัวรับวิดีโอ ซึ่งจะส่งสตรีมวิดีโอไปยัง RAM ของระบบฝังตัวโดยใช้ตัวควบคุมการเข้าถึงหน่วยความจำโดยตรง (DMA) จากนั้นข้อมูลวิดีโอจะถูกอ่านจากหน่วยความจำและส่งไปยังตัวควบคุมการเข้าถึงสื่ออีเธอร์เน็ต (MAC) โดยใช้กลไกการออกแบบสแต็กเครือข่ายอย่างใดอย่างหนึ่งต่อไปนี้: (1) ชุดพัฒนา Data Plane (DPDK) 7หรือ (2) การใช้งานเครือข่ายแบบดั้งเดิมที่ใช้เคอร์เนล Linux 8สุดท้ายแล้ว Ethernet MAC จะส่งต่อแพ็กเก็ตเครือข่ายไปยัง Ethernet PHY ที่เชื่อมต่ออยู่

รูปที่ 3. การสตรีมวิดีโอแบบคลาสสิกโดยใช้หน่วยความจำ

ภาพที่ 4 แสดงให้เห็นถึงวิธีการใช้งานลำดับการส่งข้อมูลโดยใช้การเข้าถึงหน่วยความจำโดยตรงระยะไกล (RDMA) โดยแสดงให้เห็นถึงความจำเป็นในการใช้การ์ดอินเทอร์เฟซเครือข่าย (NIC) ที่รองรับ RDMA สำหรับทั้งฝั่งผู้ส่งและผู้รับ ดังที่แสดงในแผนภาพ การใช้งานเลเยอร์ 2 พื้นฐานนั้นอิงตามมาตรฐานอีเธอร์เน็ต ลำดับตัวอย่างนี้เป็นภาพรวมที่แสดงให้เห็นถึงวิธีการใช้งานการส่งข้อมูล RDMA ผ่านอีเธอร์เน็ตคอนเวอร์เจนซ์ (RoCE)

รูปที่ 4 การส่งสัญญาณวิดีโอโดยใช้ RDMA

ภาพที่ 5 นำเสนอภาพรวมของแนวทางในบทความนี้ โดยเผยให้เห็นส่วนประกอบที่สำคัญที่สุด ได้แก่ การแปลงเส้นทางวิดีโอที่ใช้ FPGA ไปเป็นแพ็กเก็ต RTP และโมดูลสแต็กเครือข่ายแบบไร้การเชื่อมต่อ

รูปที่ 5. เครื่องมือสตรีมมิ่งวิดีโอที่เร่งความเร็วด้วย FPGA

ภาพที่ 6 แสดงการแปลงข้อมูลวิดีโอ CSI-2 ไปเป็นการแปลงแพ็กเก็ต RTP อย่างสมบูรณ์ เพื่อประสิทธิภาพในการออกแบบการแปลง จึงเลือกการแปลงแบบ 1 บรรทัดเป็น 1 แพ็กเก็ต RTP ซึ่งเป็นวิธีที่ดีที่สุดทั้งในแง่ของการใช้ทรัพยากรและมาตรฐานอีเธอร์เน็ต เฟรมอีเธอร์เน็ตทั่วไปที่อิงตามหน่วยการส่งข้อมูลสูงสุด (MTU) ซึ่งเป็นหน่วยวัดที่ใช้ใน NIC ที่ผลิตจริง มีช่วง 1500 (ปกติ) หรือ 9000 (เฟรมจัมโบ้) และค่าสูงสุดทางทฤษฎี 65536 (เฟรมขนาดใหญ่พิเศษ) สำหรับกรณีการใช้งานทดลอง เนื่องจากวิดีโอหนึ่งบรรทัดแสดงถึงหลายพันไบต์ จึงเลือกสถาปัตยกรรมแบบ 1 บรรทัดเพื่อให้สอดคล้องกับการออกแบบ NIC ของตัวรับส่วนใหญ่ ดังที่ได้กล่าวไว้ก่อนหน้านี้ การแปลงข้อมูลวิดีโอเป็นแพ็กเก็ต RTP แบบซอฟต์แวร์อย่างเดียวหรือแบบฮาร์ดแวร์/ซอฟต์แวร์นั้นเกี่ยวข้องกับการอ่าน/เขียนหน่วยความจำจำนวนมากทั้งในระบบย่อยซอฟต์แวร์วิดีโอและเครือข่าย ซึ่งเพิ่มความซับซ้อนและลดประสิทธิภาพลงเนื่องจากความหน่วงสูง ในแนวทางฮาร์ดแวร์แบบเต็มรูปแบบนี้ ความซับซ้อนของการใช้งานจะลดลงเหลือน้อยที่สุด โดยมีกลไกการจัดเก็บข้อมูลเพียงอย่างเดียวสำหรับช่วงเวลาการส่งข้อมูลของแต่ละเส้นทาง จึงมั่นใจได้ว่าแพ็กเก็ตที่ส่งผ่านสายเคเบิลจะไม่ถูกแบ่งส่วน ในทางกลับกัน กลไกที่เรียบง่ายอย่างยิ่งนี้มีประโยชน์เฉพาะสำหรับการแปลงข้อมูลจากกลุ่มสตรีมวิดีโอที่แบ่งเวลาโดยใช้ความสามารถของช่องสัญญาณเสมือนเท่านั้น ในกรณีที่ใช้กลุ่มสตรีมวิดีโอที่แบ่งเวลาหลายกลุ่มแบบขนานกัน จำเป็นต้องเพิ่มระดับการจัดเก็บข้อมูลใหม่ลงในลำดับชั้นการส่งข้อมูล ซึ่งจะสร้างเส้นทางที่แบ่งเวลาไปยังระบบย่อยเครือข่าย

รูปที่ 6 การแปลงพิกเซลวิดีโอ (หนึ่งบรรทัด) เป็นแพ็กเก็ต RTP

ดังแสดงในรูปที่ 6 กระบวนการแปลประกอบด้วยสองขั้นตอน: (1) รวบรวมข้อมูลจากการใช้งานตัวรับ CSI-2 และสร้างแพ็กเก็ตตามสตรีมวิดีโอที่สอดคล้องกับ AXIS และ (2) สร้างแพ็กเก็ต RTP โดยการเพิ่มส่วนหัวโปรโตคอลลงในสตรีมวิดีโอ

แพลตฟอร์มการประมวลผลแบบ Edge Computing ADI GMSL ไปยัง 10 GbE

เพื่อใช้ประโยชน์จากข้อดีของการออกแบบการสตรีมวิดีโอ RTP ที่เร่งความเร็วด้วย FPGA อย่างเต็มรูปแบบ ADI จึงนำเสนอแพลตฟอร์มการประมวลผลแบบ Edge Computing รุ่น ADRD8012-01Z ซึ่งเป็นตัวแปลงสัญญาณ GMSL หลายกล้องประสิทธิภาพสูงเป็น 10 Gigabit Ethernet (GbE) ที่สร้างขึ้นบน AMD-Xilinx K26 SoM ที่คุ้มค่า ฮาร์ดแวร์ประกอบด้วยตัวแปลงสัญญาณอนุกรม MAX96724 สองตัวที่มี 4GMS ซึ่งสามารถรองรับสตรีมวิดีโอแบบขนานได้สูงสุด 8 กล้อง โดยแสดงเป็น 2 บล็อกของ 4 ช่องสัญญาณเสมือน (VC - VC0 ถึง VC3) ก่อนตัวแปลงสัญญาณอนุกรม ภาพที่ 7 แสดงลำดับการสตรีมวิดีโอทั้งหมด ในแง่ของเครือข่าย แพลตฟอร์มนี้มีขั้วต่อแบบเสียบได้ (SFP+) ที่สามารถใช้เพื่อส่งข้อมูลผ่านเครือข่าย 10 GbE ได้ โมดูลกล้องที่ทดสอบกับการใช้งานการสตรีมวิดีโอของผลิตภัณฑ์นี้มีดังนี้: กล้องระดับยานยนต์ C1 และ C2 คลาส IV ที่มีช่วงไดนามิกสูงถึง 120 dB และความละเอียด 2.5 MP/5.4 MP และ Intel RealSense D457 นอกจากนี้ โมดูลยังประกอบด้วยตัวประมวลผลภาพ (ISP) ในตัวที่เชื่อมต่อกับเซ็นเซอร์ภาพแต่ละตัว ทำให้สามารถส่งภาพสีเต็มรูปแบบตามข้อกำหนด YUV422 ได้ ตัวอย่างเช่น ดังที่กล่าวไว้ก่อนหน้านี้ ในบริบทของการสตรีมวิดีโอ ข้อกำหนดของเลเยอร์แอปพลิเคชันทำหน้าที่เป็นพื้นฐานสำหรับการแสดงโครงสร้างของเฟรม ในกรณีนี้ สำหรับการส่งวิดีโอแบบไม่บีบอัด ส่วนหัวของเพย์โหลด RTP 6จะกำหนดความยาวของแต่ละฟิลด์เพย์โหลด ซึ่งระบุความยาวบรรทัดจริง จำนวนบรรทัด และปัจจัยอื่นๆ ที่เกี่ยวข้องกับการแบ่งส่วนซึ่งไม่ได้พิจารณาในแนวทางของเอกสารนี้ ในทางกลับกัน ส่วนหัว RTP ทั่วไป4แสดงประเภทวิดีโอและค่าตัวระบุเครื่องหมาย โดยระบุไบต์สุดท้ายของเฟรมวิดีโอ ซึ่งตรงกับส่วนตรรกะ TVALID/TLAST ของ eXtensible Interface Streaming (AXIS) อย่างสมบูรณ์

รูปที่ 7. ลำดับการสตรีมวิดีโอ RTP บน ADRD8012-01z

สรุป

บทความนี้แสดงให้เห็นว่าการส่งสัญญาณวิดีโอความเร็วสูงในพื้นที่ที่รองรับโดย GMSL สามารถปรับขนาดได้อย่างมีประสิทธิภาพไปสู่โครงสร้างพื้นฐานการสตรีมวิดีโอประสิทธิภาพสูง โดยยังคงรักษาประสิทธิภาพอัตราการส่งข้อมูลเท่าเดิมและให้พฤติกรรมที่มีความหน่วงต่ำ เพื่อนำสถาปัตยกรรมที่แข็งแกร่งและมีประสิทธิภาพนี้ไปใช้ จึงได้เลือกใช้อุปกรณ์ FPGA SoC อุปกรณ์ที่เลือกนี้มีทั้งทรัพยากร CPU และ FPGA ซึ่งรวมความสามารถทั้งด้านซอฟต์แวร์และฮาร์ดแวร์เข้าด้วยกันเพื่อสร้างเครื่องมือสตรีมวิดีโอแบบเรียลไทม์หลายกล้องที่มีประสิทธิภาพสูง